Guia rápido
Esta página leva você do zero a um estudo de PDDE (SDDP) concluído em três comandos, usando o
modelo embutido 1dtoy. O modelo representa um sistema hidrotérmico com um único barramento,
uma usina hidrelétrica e duas unidades termelétricas, ao longo de um horizonte de planejamento finito de 4 estágios — pequeno
o bastante para rodar em segundos e completo o bastante para demonstrar cada etapa do fluxo de trabalho.
Se você ainda não instalou o Novo Modelo, comece pela Instalação.
Passo 1: crie o diretório do caso
Seção intitulada “Passo 1: crie o diretório do caso”novomodelo init --template 1dtoy my_first_studyO Novo Modelo grava 11 arquivos de entrada em um novo diretório my_first_study/ e imprime um
resumo no stderr:
 ╺━━━━━━━━━╻● ╺━━━━━━━━━╻●⚡  NOVOMODELO v0.21.0 ╺━━━━━━━━━╻●   Power systems in Rust
Created my_first_study case directory from template '1dtoy':
  ✔ config.json  Algorithm configuration: training (forward passes, stopping rules) and simulation settings  ✔ initial_conditions.json  Initial reservoir storage volumes for each hydro plant at the start of the planning horizon  ✔ penalties.json  Global penalty costs for constraint violations (deficit, excess, spillage, storage bounds, etc.)  ✔ stages.json  Planning horizon definition: policy graph type, discount rate, stage dates, time blocks, and scenario counts  ✔ system/buses.json  Electrical bus definitions with deficit cost segments  ✔ system/hydros.json  Hydro plant definitions: reservoir bounds, outflow limits, turbine model, and generation limits  ✔ system/hydro_production_models.json  Per-(hydro, stage) production-model configuration carrying the productivity coefficient  ✔ system/lines.json  Transmission line definitions (empty in this single-bus example)  ✔ system/thermals.json  Thermal plant definitions with piecewise cost segments and generation bounds  ✔ scenarios/inflow_seasonal_stats.parquet  Seasonal PAR(p) statistics for hydro inflow scenario generation (mean, std, lag correlations)  ✔ scenarios/load_seasonal_stats.parquet  Seasonal PAR(p) statistics for electrical load scenario generation (mean, std, lag correlations)
Next steps:  -> novomodelo validate my_first_study  -> novomodelo run my_first_study --output my_first_study/results
A estrutura do diretório é:
my_first_study/ config.json initial_conditions.json penalties.json stages.json system/ buses.json hydros.json hydro_production_models.json lines.json thermals.json scenarios/ inflow_seasonal_stats.parquet load_seasonal_stats.parquetPasso 2: valide o caso
Seção intitulada “Passo 2: valide o caso”novomodelo validate my_first_studyO processo de validação verifica todas as camadas — esquema, referências, viabilidade
física e consistência estocástica — e então
monta o estudo como novomodelo run faz e verifica qualquer política que a execução carregaria,
sem resolver nenhum PL, e imprime, em caso de sucesso, uma única linha com a contagem de entidades:
Valid case: 1 buses, 1 hydros, 2 thermals, 0 linesEssa é toda a saída para um caso sem avisos; um caso que gera avisos
acrescenta um resumo Validation: 0 errors, N warnings in <dir> e uma linha warning:
por ocorrência. Se alguma camada falhar, o Novo Modelo imprime um resumo
Validation: N errors, 0 warnings in <dir> seguido de cada erro
prefixado com error:, e termina com código diferente de zero: 1 para um caso recusado, 2 para um arquivo de árvore de aberturas declarado mas ausente
(veja Referência da CLI — Códigos de saída). O modelo 1dtoy sempre passa
na validação.
Passo 3: execute o estudo
Seção intitulada “Passo 3: execute o estudo”novomodelo run my_first_study --output my_first_study/resultsO Novo Modelo executa o laço de treinamento (training) da PDDE (128 iterações, 1 simulação forward em cada) seguido de
uma simulação final (100 cenários). A saída é gravada em my_first_study/results/.
O banner, um cabeçalho de execução/preparação, o progresso e o resumo pós-execução
são impressos no stdout; avisos e erros vão para o stderr. Em um terminal, as barras de
progresso são desenhadas no stderr. O resumo de cada fase segue seu progresso; este trecho
começa no resumo do treinamento e omite as linhas de progresso da simulação:
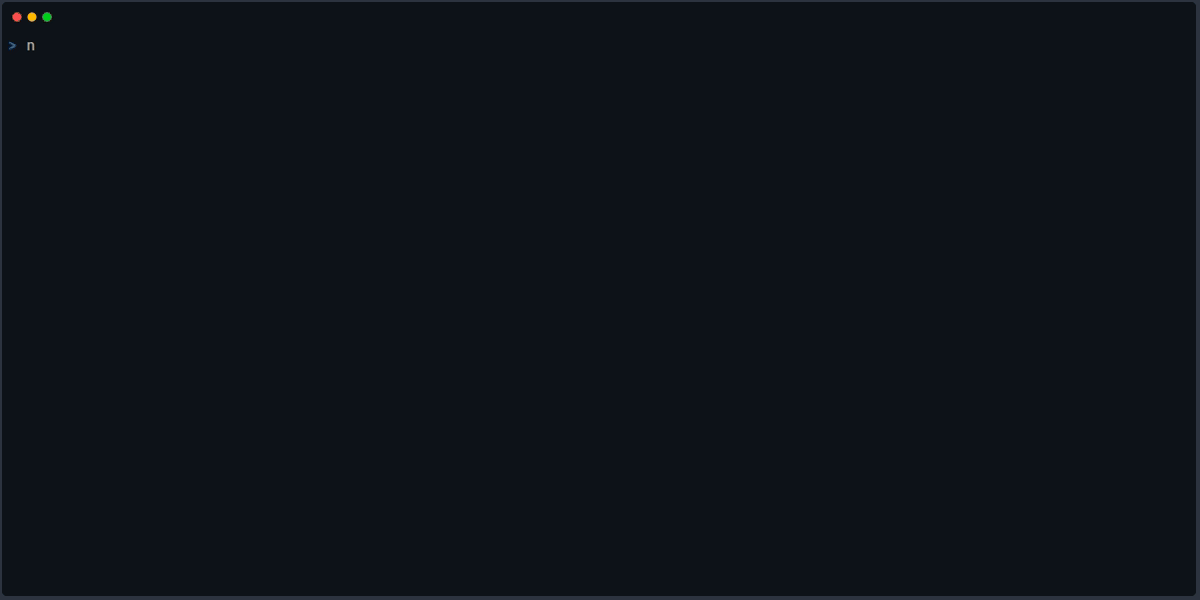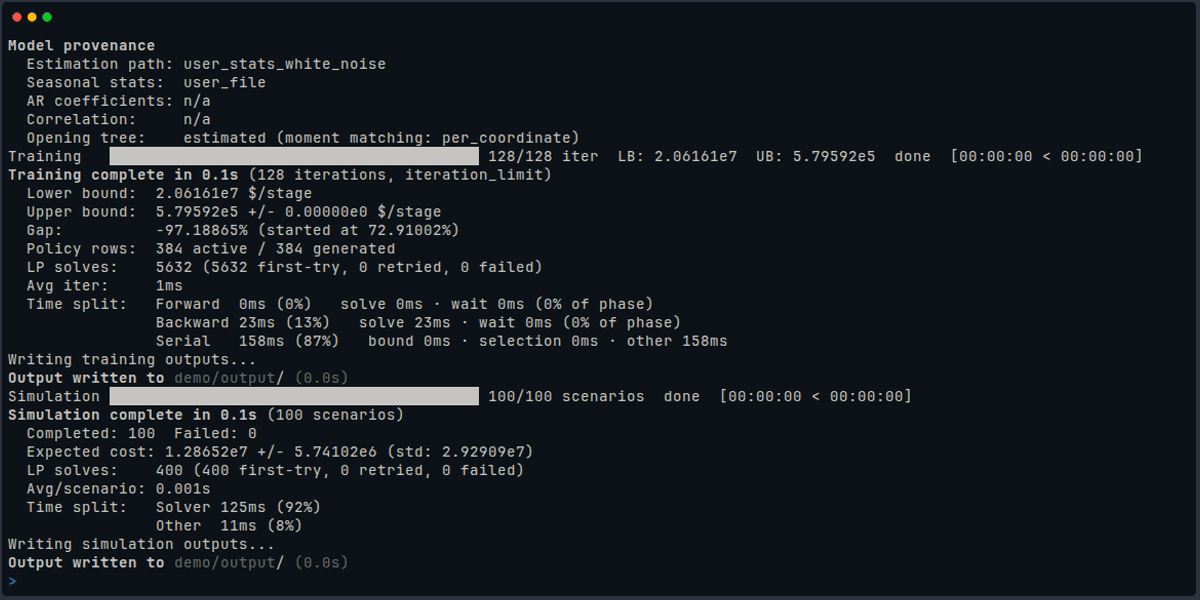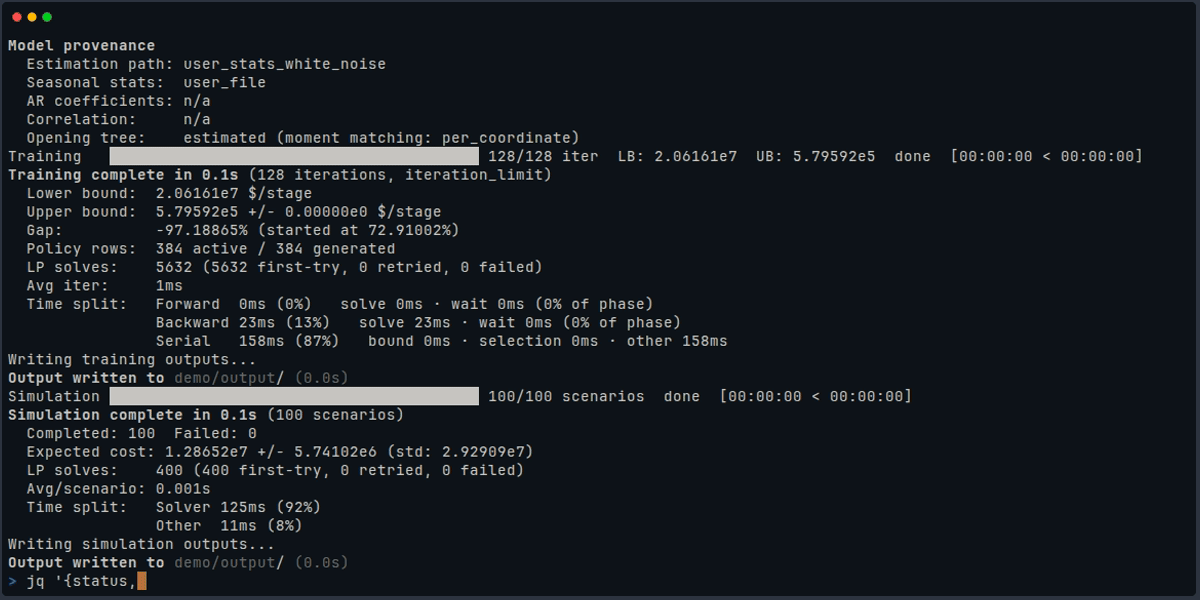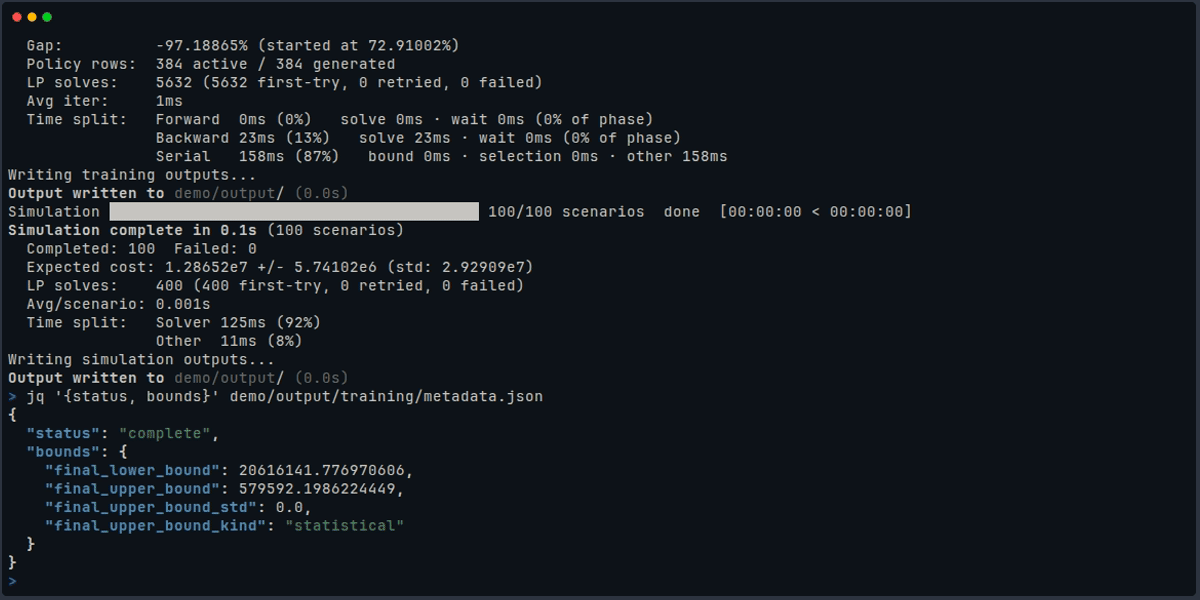
Training complete in 0.5s (128 iterations, iteration_limit) Lower bound: 2.06161e7 $/stage Upper bound: 5.79592e5 +/- 0.00000e0 $/stage Gap: -97.18865% (started at 72.91002%) Policy rows: 384 active / 384 generated LP solves: 5632 (5632 first-try, 0 retried, 0 failed) Avg iter: 4ms Time split: Forward 2ms (<1%) solve 2ms · wait 0ms (0% of phase) Backward 237ms (44%) solve 237ms · wait 0ms (0% of phase) Serial 298ms (55%) bound 85ms · selection 0ms · other 213msWriting training outputs...Output written to my_first_study/results/ (0.0s)Simulation starting... (100 scenarios across 1 ranks × 1 threads)Simulation complete in 0.5s (100 scenarios) Completed: 100 Failed: 0 Expected cost: 1.28652e7 +/- 5.74102e6 (std: 2.92909e7) LP solves: 400 (400 first-try, 0 retried, 0 failed) Avg/scenario: 0.006s Time split: Solver 328ms (59%) Other 231ms (41%)Writing simulation outputs...Output written to my_first_study/results/ (0.0s)O diretório de resultados contém os dados de convergência do treinamento, um checkpoint da política
em FlatBuffers e arquivos Parquet particionados no estilo Hive com os resultados de despacho da simulação.
Isto é o que o modelo 1dtoy produz:
my_first_study/results/ training/ _SUCCESS metadata.json convergence.parquet hydro_models.json model_provenance.json scaling_report.json dictionaries/ solver/ timing/ policy/ manifest.bin cuts/ 000.bin ... 003.bin basis/ 000.bin ... 003.bin simulation/ _SUCCESS metadata.json paths.parquet scenario_summary.parquet buses/ costs/ hydro_bus_generation/ hydros/ inflow_lags/ solver/ thermals/A árvore depende do modelo de caso. policy/basis/ contém um arquivo por estágio somente quando
o treinamento produziu uma base para aproveitamento (warm-start da base) naquele estágio (o próprio diretório é
sempre criado), e casos com outras entidades acrescentam outras partições
da simulação — por exemplo pumping_stations/, contracts/, in_transit/ e
violations/ de restrições genéricas. Consulte Formato de saída
para o esquema oficial e condicional de cada arquivo.
O que você acabou de executar
Seção intitulada “O que você acabou de executar”O caso 1dtoy tem um barramento cuja demanda não atendida (déficit) custa 7500 $/MWh. A usina hidrelétrica
UHE1 tem um reservatório de 1000 hm³ que começa com 83,222 hm³ e turbina até 50 m³/s com
1 MW por m³/s. As usinas termelétricas UTE1 e UTE2 fornecem 15 MW cada, a 5 e 10 $/MWh.
A demanda é constante, de 75 MW.
O horizonte tem quatro estágios mensais, do estágio 1 (janeiro de 2024) ao estágio 4 (abril de 2024), com
um patamar de carga cada. Cada estágio sorteia dez aberturas de afluência (num_openings) a partir das
estatísticas sazonais em scenarios/ (média de 40 m³/s), sem defasagens autorregressivas. A taxa
de desconto anual é 0,12.
Os arquivos de configuração e as saídas identificam os mesmos estágios pelo stage_id declarado,
de 0 a 3 aqui; os arquivos da política 000.bin … 003.bin são numerados a partir de 0 na ordem dos estágios.
Veja Indexação dos estágios.
Para uma iteração da PDDE resolvida à mão em um sistema com um reservatório, veja o Exemplo didático de PDDE com um reservatório; o Exemplo didático de PDDE com quatro reservatórios o estende a quatro reservatórios.
Como ler o resumo
Seção intitulada “Como ler o resumo”- Unidades. O limite inferior, o limite superior e o custo esperado são, cada um, um total
esperado para todo o horizonte: os custos dos quatro estágios, descontados para o início do estágio 1,
na moeda dos custos do caso. Apesar do rótulo
$/stage, nenhum deles é um valor por estágio. - Faixa. O número após
+/-na linhaUpper boundé o desvio-padrão dos custos das simulações forward daquela iteração. Comforward_passes: 1há um custo por iteração, de modo que a dispersão é zero e a linha imprime+/- 0.00000e0. Na linhaExpected cost,+/-é a semiamplitude do intervalo de confiança de 95 % para a média estdé o desvio-padrão dos custos dos cenários. - Gap negativo. O limite superior é o custo da única trajetória amostrada na iteração. O gap de otimalidade é esse custo menos o limite inferior, relativo ao limite inferior, de modo que uma trajetória mais barata que o limite inferior produz um gap negativo. A maioria das trajetórias deste caso custa cerca de 6e5; as que ficam sem água pagam o custo de déficit, chegando a cerca de 2e8 ao longo das 128 iterações. A última iteração sorteou uma barata. Com simulações forward amostradas, o gap é uma estimativa, não uma garantia.
- Limite inferior acima da média simulada. O
limite inferior é o valor esperado do primeiro estágio
sobre suas dez aberturas, com os cortes treinados. O custo esperado é a média de 100
cenários sorteados das mesmas dez aberturas por estágio. O desvio-padrão deles
(2,92909e7) é mais que o dobro da média: a maioria dos cenários é barata e alguns são muito
caros, de modo que uma média de 100 cenários frequentemente fica abaixo do custo esperado que estima,
e o limite inferior nunca excede esse custo esperado. Um valor maior de
simulation.selection.num_scenariosestreita o intervalo. - Reprodutibilidade. Os limites, o gap, o custo esperado e as contagens de linhas da política e
de resoluções de PL são os mesmos em toda execução; apenas os tempos variam conforme a máquina. As
dez aberturas de afluência e os sorteios dentro da amostra (in-sample) usam a semente
training.tree_seed(não definida no modelo, de modo que se aplica o padrão 42).training.scenario_source.seeddefine a semente apenas dos sorteios fora da amostra (out-of-sample), que este caso não usa; Resolução das sementes descreve ambas as sementes. Alterartraining.tree_seed, o critério de parada ouforward_passesaltera os limites. O formato completo do resumo, incluindo o blocoTime split, está documentado em Referência da CLI — Formato da saída.
Passo 4: leia os resultados
Seção intitulada “Passo 4: leia os resultados”O histórico de convergência e os custos da simulação são arquivos Parquet comuns. Instale
polars e matplotlib com
pip install polars matplotlib e execute os trechos a partir do diretório que contém
my_first_study/. O primeiro imprime as três últimas iterações de
training/convergence.parquet e resume os custos por cenário em
simulation/costs/:
import polars as pl
conv = pl.read_parquet("my_first_study/results/training/convergence.parquet")print(conv.select("iteration", "lower_bound", "upper_bound", "gap_percent").tail(3))
costs = pl.read_parquet("my_first_study/results/simulation/costs/")per_scenario = costs.group_by("scenario_id").agg(    (pl.col("discount_factor") * pl.col("immediate_cost")).sum().alias("cost"))print(per_scenario.select(    pl.col("cost").mean().alias("mean"),    pl.col("cost").median().alias("median"),    pl.col("cost").max().alias("max"),))
shape: (3, 4)┌───────────┬─────────────┬───────────────┬─────────────┐│ iteration ┆ lower_bound ┆ upper_bound ┆ gap_percent ││ --- ┆ --- ┆ --- ┆ --- ││ i32 ┆ f64 ┆ f64 ┆ f64 │╞═══════════╪═════════════╪═══════════════╪═════════════╡│ 126 ┆ 2.0616e7 ┆ 615923.497494 ┆ -97.012421 ││ 127 ┆ 2.0616e7 ┆ 615923.497494 ┆ -97.012421 ││ 128 ┆ 2.0616e7 ┆ 579592.198622 ┆ -97.188649 │└───────────┴─────────────┴───────────────┴─────────────┘shape: (1, 3)┌──────────┬───────────────┬──────────┐│ mean ┆ median ┆ max ││ --- ┆ --- ┆ --- ││ f64 ┆ f64 ┆ f64 │╞══════════╪═══════════════╪══════════╡│ 1.2865e7 ┆ 615923.497494 ┆ 1.4053e8 │└──────────┴───────────────┴──────────┘A última linha repete os limites e o gap do resumo, e a média é o custo esperado
do resumo; a mediana mostra que a maioria dos cenários é barata e o máximo, que alguns são muito
caros — a cauda longa descrita em Como ler o resumo. O
custo de um cenário neste caso é a soma, ao longo dos estágios, de discount_factor * immediate_cost; total_cost
também inclui a estimativa de custo futuro, de modo que somá-lo não reproduz o custo esperado.
O segundo trecho traça os dois limites em função do número da iteração. Ele grava
convergence.png no diretório de trabalho, portanto roda sem tela:
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport polars as pl
conv = pl.read_parquet("my_first_study/results/training/convergence.parquet")fig, ax = plt.subplots()ax.plot(conv["iteration"], conv["lower_bound"], label="lower bound")ax.plot(conv["iteration"], conv["upper_bound"], label="upper bound (one forward pass)")ax.set_yscale("log")ax.set_xlabel("iteration")ax.set_ylabel("expected cost")ax.legend()fig.savefig("convergence.png")print("saved convergence.png")
saved convergence.pngEm convergence.png, no eixo logarítmico, o limite inferior sobe a partir de 1,23e7 e se estabiliza perto de 2,06e7, enquanto o
limite superior de uma única simulação forward fica perto de 6e5 na maioria das iterações, com picos de até 1,99e8.
Convergência e diagnóstico descreve cada arquivo de saída, e o Guia rápido em Python executa e lê o mesmo estudo a partir do Python.
Passo 5: reduza o ruído de amostragem
Seção intitulada “Passo 5: reduza o ruído de amostragem”O limite superior no Passo 3 vem de uma simulação forward por iteração e o custo esperado,
de 100 cenários; portanto, ambos são estimativas ruidosas. Duas chaves de config.json controlam esse
ruído: training.selection.forward_passes, o número de trajetórias amostradas em cada
iteração, e simulation.selection.num_scenarios, o número de cenários simulados.
Defina esses dois valores em my_first_study/config.json e mantenha todas as demais chaves; este
trecho mostra os dois objetos:
{ "training": { "selection": { "method": "sampled", "forward_passes": 10 } }, "simulation": { "selection": { "method": "sampled", "num_scenarios": 2000 } }}Execute o estudo novamente em um segundo diretório de saída, para que os resultados do Passo 3 continuem disponíveis para comparação. A simulação de 2000 cenários grava cerca de 10.000 arquivos, aproximadamente 70 MB:
novomodelo run my_first_study --output my_first_study/results-moreO resumo pós-execução, em trecho (os tempos variam conforme a máquina):
Training complete in 10.9s (128 iterations, iteration_limit) Lower bound: 2.06178e7 $/stage Upper bound: 1.73930e7 +/- 2.30248e7 $/stage Gap: -15.64066% (started at -13.72705%) Policy rows: 3840 active / 3840 generatedSimulation complete in 31.2s (2000 scenarios) Completed: 2000 Failed: 0 Expected cost: 2.16935e7 +/- 1.92862e6 (std: 4.40053e7)Com esses valores, o limite superior de cada iteração é a média de dez custos de trajetória, impressa
com seu desvio-padrão, e o gap (-15,64066 % na última iteração) continua sendo uma
estimativa que varia de iteração para iteração. O custo esperado dos 2000 cenários é
um intervalo de confiança de 95 %, 2.16935e7 +/- 1.92862e6, que contém o limite inferior; assim, os dois concordam
dentro do ruído de amostragem. O limite inferior termina ligeiramente acima do Passo 3, em 2.06178e7,
com dez
cortes adicionados por estágio em cada iteração (3840 linhas da política: 128 iterações, dez cortes para cada
um dos três estágios que recebem cortes). Um gap exato, e o critério
de parada gap, exigem seleção forward enumerada, que as dez aberturas por estágio deste caso não
admitem; Convergir até um gap
apresenta a configuração.
Próximos passos
Seção intitulada “Próximos passos”Você concluiu um estudo completo de PDDE, da preparação do caso aos resultados. As páginas a seguir aprofundam como o caso é estruturado e como interpretar a saída:
- Formato do caso — o que cada arquivo de entrada controla
- Convergência e diagnóstico — como ler a saída Parquet e avaliar a convergência
- Referência da CLI — todas as flags, subcomandos e códigos de saída
- Configuração — todos os campos de
config.jsondocumentados